代码图
代码图是一个 SQLite 数据库——.code-graph/graph.db——保存仓库的结构关系。定义、调用、导入、继承、文件 → 文件的边。你的 AI 代理通过 MCP 工具查询它,而不是为每个问题重新 grep。
图里有什么
两张表,就是 sqlite3 .code-graph/graph.db ".schema" 打印出来的样子:
CREATE TABLE nodes (
    id         TEXT PRIMARY KEY,   -- content hash, not an autoincrement integer
    kind       TEXT NOT NULL,      -- file | function | method | class | interface | enum | table
    name       TEXT NOT NULL,
    file       TEXT NOT NULL,      -- repo-relative path
    start_line INTEGER,
    end_line   INTEGER
);
CREATE INDEX idx_node_file ON nodes(file);

CREATE TABLE edges (
    src  TEXT NOT NULL,            -- always a nodes.id
    dst  TEXT NOT NULL,            -- a nodes.id, or a raw name (see below)
    kind TEXT NOT NULL             -- imports | contains | calls | inherits
                                   -- | implements | depends_on | tests_for
);
CREATE UNIQUE INDEX uq_edges  ON edges(src, dst, kind);
CREATE INDEX idx_edge_dst ON edges(dst);
没有 language 列——语言在解析时从扩展名推断,不存进库。
dst 不一定是节点 id。 contains、tests_for 和 depends_on 能解析到 nodes 里的一行。imports 和 inherits 存的是解析器看到的原始文本——'../api/metricsClient'、'argparse'、一个基类名——因为把模块路径解析成文件需要解析器不跑的一套规则。前一组用 join,后一组用匹配。下面的例子两种各一个。
这些都能直接用 sqlite3 查。MCP 服务器只是同一个文件之上的类型化便利层。
支持的语言
tree-sitter 解析器支持:Python、TypeScript、JavaScript、Go、Rust、Java、C#、Ruby 等。没有 tree-sitter 包的语言自动回退到正则解析器——覆盖度下降,但构建不会失败。
完整列表见 .github/code-graph/requirements.txt。
MCP 工具
MCP 服务器向代理暴露以下查询:
| 工具 | 用途 |
|---|---|
get_minimal_context(task) | 默认首调。 把任务里提到的符号解析到图上,返回 files_to_read:定义所在的文件、它们依赖的文件,再加一层依赖它们的文件,排序后最多 6 个。同时还有图的规模、未提交改动的风险,以及下一个该用的工具。控制在 ~150 token 以内,所以不带逐文件的 token 统计——需要就把 files_to_read 交给 get_review_context。空列表一定带着 files_reason。 |
query_graph(pattern, node_name) | 具名模式:callers_of、callees_of、imports_of、importers_of、tests_for、file_summary。 |
get_impact_radius(files) | 传入的是一组仓库相对路径,不是符号。返回从它们可达的文件。 |
get_review_context(files, budget_tokens?) | 评审用:这些文件加上直接邻居,排序后按 token 预算裁剪。 |
find_large_functions(min_lines=50) | 超过 N 行的函数——技术债扫描。 |
detect_changes(base="HEAD") | 自指定 ref 以来 SHA-1 变化的文件。 |
update_graph() | 增量重新解析变化的文件。 |
build_graph() | 从零完整重建。 |
graph_stats() | 节点 + 边数量、上次更新时间、按语言分的文件数。 |
visualize_graph() | 在 .code-graph/graph.html 渲染交互式 HTML 图。 |
可视化
uv run --with-requirements .github/code-graph/requirements.txt \
  .github/code-graph/server.py --visualize
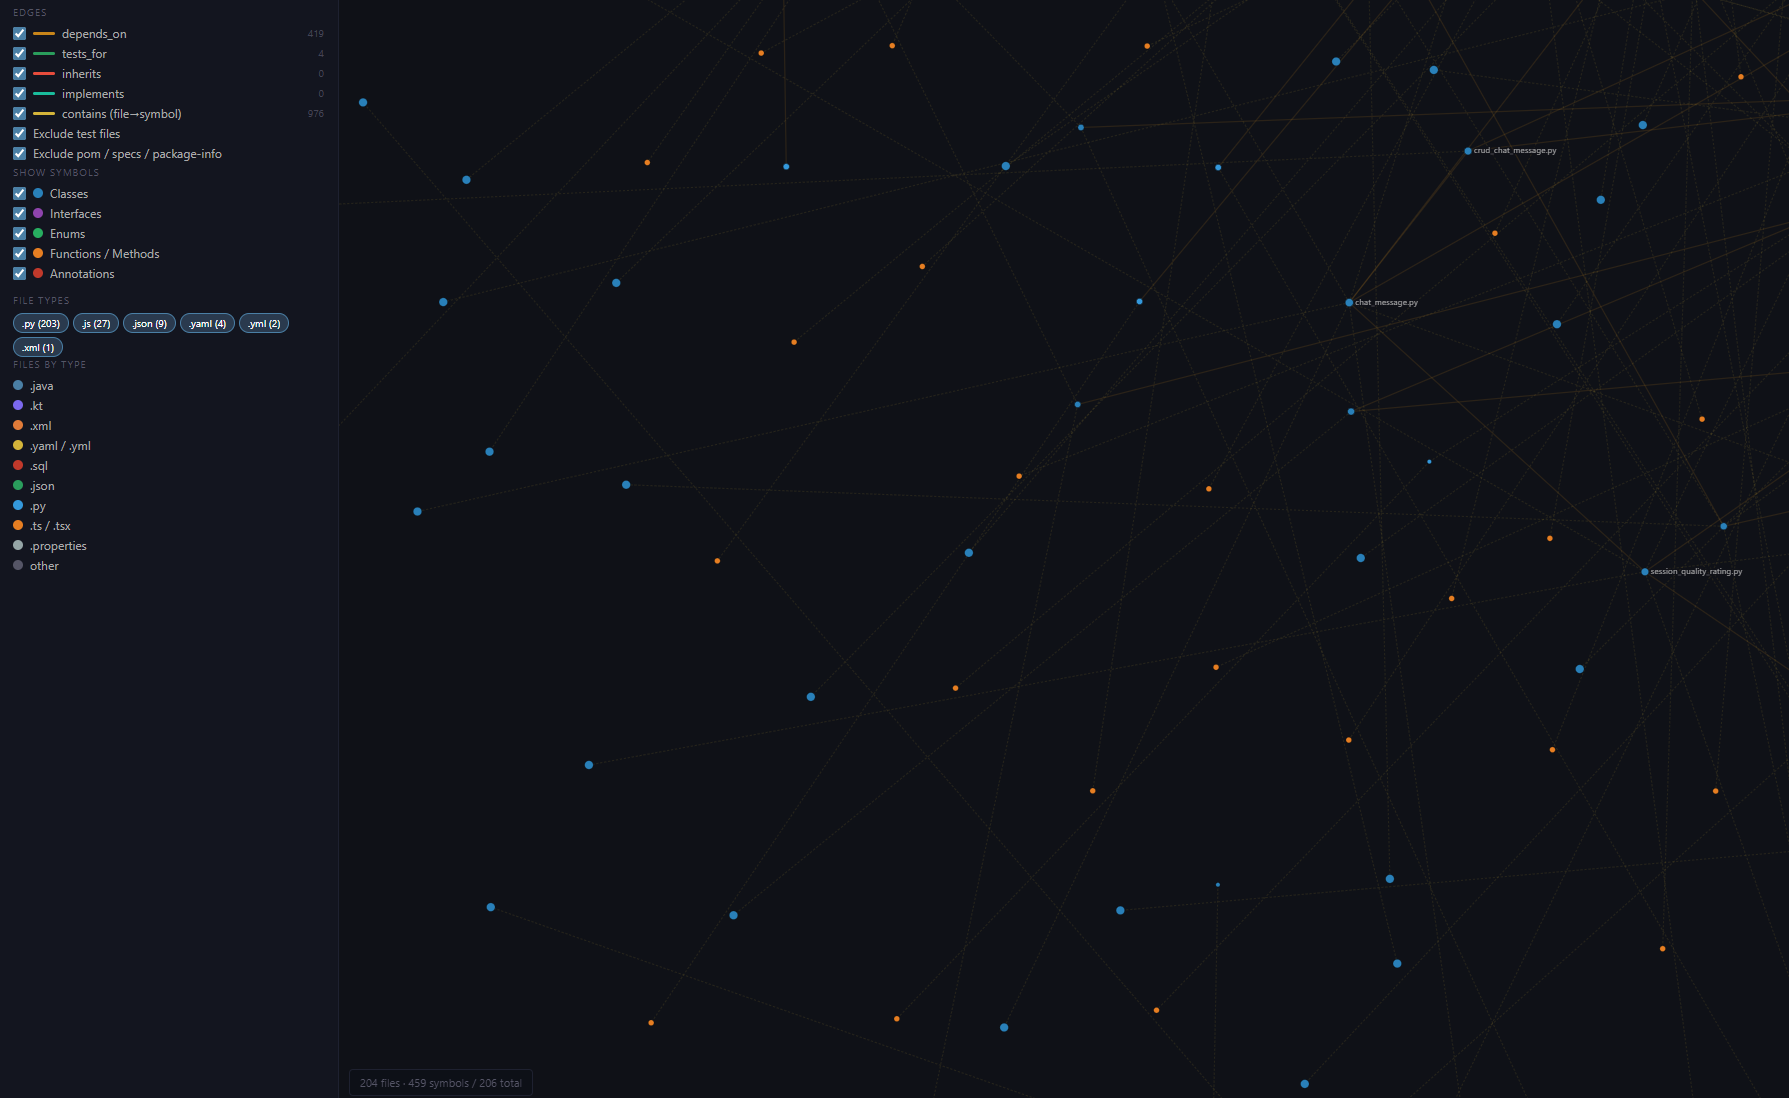
输出 .code-graph/graph.html——独立的 D3 力导向视图(不需要服务器)。用任何浏览器打开。拖动节点、悬停看符号详情、按语言或类型筛选。用于检查新构建是否正确、找出孤立模块,以及给队友展示代理实际看到的内容。
为什么选 SQLite
- 查询零依赖。 任何装了
sqlite3的人都能直接戳图,不用启动 MCP 服务器。 - 便宜。 5 万行代码库的图通常只有几 MB。
- 跨机器稳定。 队友从同一个提交重建图能拿到同样的数据库——测试夹具级别的可复现性。
直接走 SQL
如果没有 MCP,数据库就是一个文件:
# 一个文件里的所有定义,按源码顺序
sqlite3 -header -column .code-graph/graph.db "
  SELECT child.kind, child.name, child.start_line
  FROM edges e
  JOIN nodes parent ON parent.id = e.src
  JOIN nodes child  ON child.id  = e.dst
  WHERE parent.file = 'src/i18n/t.ts' AND e.kind = 'contains'
  ORDER BY child.start_line;
"
kind name start_line
-------- ---------------------- ----------
function localizedPath 43
function detectLocaleFromHeader 49因为 imports 的目标是原始字符串,查“谁导入了某模块”要用匹配而不是 join:
sqlite3 -header -column .code-graph/graph.db "
  SELECT DISTINCT n.file
  FROM edges e
  JOIN nodes n ON n.id = e.src
  WHERE e.kind = 'imports' AND e.dst LIKE '%metricsClient'
  ORDER BY n.file;
"
这是 MCP 服务器没注册时的官方回退方案。Coograph 项目里的代理知道先试 MCP,再回退到 sqlite3,只有两者都失败时——才用 grep。
自动更新
.github/code-graph/ 里的 git 钩子(post-commit、post-merge、post-rewrite)在每次变更后调用 --update。只有内容 SHA-1 变了的文件会被重新解析。从变更文件 import 的文件也会被重新解析,跨文件的边因此保持准确。
局限
- 图捕获的是结构关系,不是语义关系。它知道
place_order调用validate;但不知道加缓存会影响下游的计费逻辑。 - 覆盖度依赖于你所用语言的 tree-sitter 可用性。回退的正则解析器能找符号,但会漏掉一些边(比如动态分发)。
- 图按文件粒度重建。如果你提交了千文件级的重构,增量更新就是 O(千文件)。