AI 编程代理的递归自我改进:哪些是真的,哪些还是理论,以及我们实际交付了什么
递归自我改进,是指一个人工智能系统改进自己“改进自己”的能力。这篇文章讲清楚理论到底说了什么,为什么模型层面的循环至今仍是理论,以及我们如何为编程代理做出了指令层面的版本,并让人守在闸门前。
递归自我改进,是指一个人工智能系统能够改进自己“改进自己”的能力。不只是把某项任务做得更好,而是把让它变好的那个过程本身做得更好,于是每一轮改进都让下一轮更快。它是你读到过的每一个“智能爆炸”论证背后的引擎;同时,它也以一种小得多、实际得多的形式存在,你今天下午就能在自己的编程代理上跑起来。
这篇文章两部分都讲。前半部分把递归自我改进讲清楚,因为大多数解释要么把它吹过头,要么一挥手打发掉。后半部分讲我们这周在 Coograph 里交付了什么:一套会衡量自身失败、并提出自身修复方案的编程代理护栏,每一处改动都由人来批准。我们叫它 Retro。它不是模型意义上的递归自我改进,我们会把这个区别说得很精确。
递归自我改进到底是什么意思
1965 年的原始论证
数学家 I. J. Good 写下了那句人人引用的话:“一台超智能机器可以设计出更好的机器;届时毫无疑问会出现一次智能爆炸,人类的智能将被远远甩在后面。”他还补充,第一台超智能机器是“人类需要做出的最后一项发明”。
论证有三步。第一,人工智能研究本身就是一项智力任务。第二,一个在这项任务上足够好的系统,能造出更好的系统。第三,更好的系统在这项任务上更好,于是它能更快地造出更好的下一代。循环自我供能。“递归”一词指的就是这个结构:一轮的输出是下一轮的输入,而被改进的东西正是做改进的东西。
为什么模型层面的循环仍然是理论
如果这个论证是完整的,我们早就活在爆炸里了。我们没有,而且原因是具体的,不是哲学的。
算力是瓶颈。一个更聪明的训练方法点子,仍然需要成千上万块加速器和数周的真实时间去验证。智能不会缩短训练跑一次的时间。
实验是瓶颈。你无法靠推理得出基准测试结果,你必须真的跑实验。循环的每一轮都在等实证反馈,而反馈以硬件的速度到达,不是以思考的速度。
验证是瓶颈。一个系统很难在不构建并评估继任者的情况下证明它更好,而这又把你送回上面两个瓶颈。
收益递减是真实存在的。容易的改进先被吃掉。之后每一轮都得找更难的东西,于是“越来越快”的故事要和一个“越来越难”的趋势对抗,而后者没人提前量化过。
截至 2026 年,大语言模型确实在写训练代码、生成合成数据、评估其他模型、自动化研究流水线的一部分。前沿实验室用自己的模型来加速自己的研究。局部的循环是存在的。一个系统在过程中完全没有人参与就改进自己的闭环,尚未被演示出来。它能否做到是一个开放的实证问题,任何满怀信心告诉你答案的人都是在猜。
为什么它对安全依然重要
如果这个循环有一天闭合并且跑得很快,对齐必须在它启动之前就做对。爆炸中途没有第二次机会去修正一个系统的目标。这就是为什么像 Anthropic 这样的组织在循环仍然是局部的时候就严肃对待这个问题。这也是为什么“递归自我改进”这个词值得尊重,而不是当营销用。这就把我们带到了我们真正做出来的东西。
同一个循环,往下一层
每一个编程代理都跑在两样东西上:一个模型,和一堆指令。模型是固定的,你没法从终端里重新训练它。指令是你的:一份 CLAUDE.md,一份 AGENTS.md,一组 hook,几个技能。那一层是你能控制的全部行为所在,而那一层有它自己的改进循环。今天,没人把它闭合。
没人闭合的循环
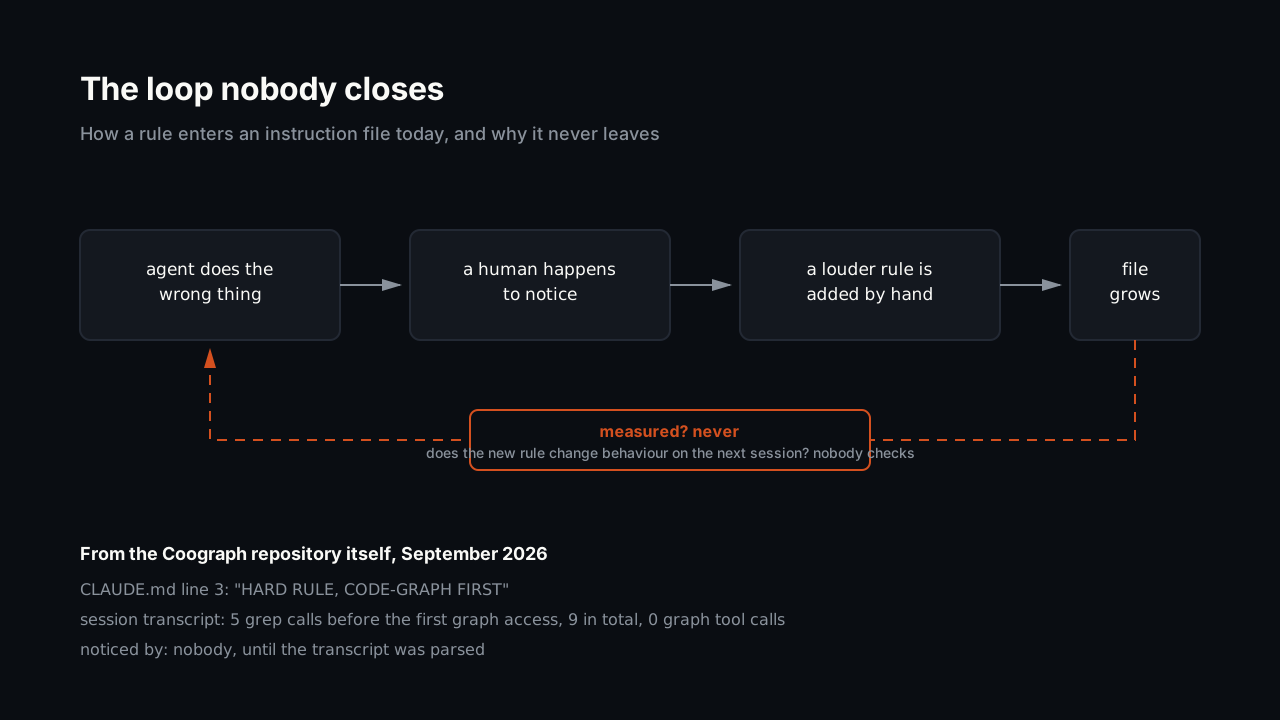
今天,一条规则是这样进入指令文件的。代理做错了什么。某个人碰巧注意到了。这个人加了一条规则,通常是已有规则的更大声版本。文件变长了。没人衡量新规则是否在下一次会话里改变了什么。
我们可以用自己的仓库给你看这件事。Coograph 的 CLAUDE.md 开头就是一条大写字母的规则:在任何 grep 之前先用代码图。在 2026 年 9 月的一份会话记录里,代理在碰到代码图之前跑了五次 grep,总共九次,而当它终于碰到代码图时,走的是一段 Python 脚本,而不是规则点名的那些工具。规则就在文件第三行。没人知道,因为没人读会话记录。
那份文件里每一句“这不算例外”或“图方便不是正当理由”,都是早先某次事故留下的疤。每一句都让文件变长,让之后每一次会话都多花 token,而违规照旧。
把它闭合
递归自我改进的结构是:在版本 N 下运行,衡量,产出版本 N+1,重复,并让这个过程改进它自己的流程。套到指令层上,这件事变得具体而廉价。
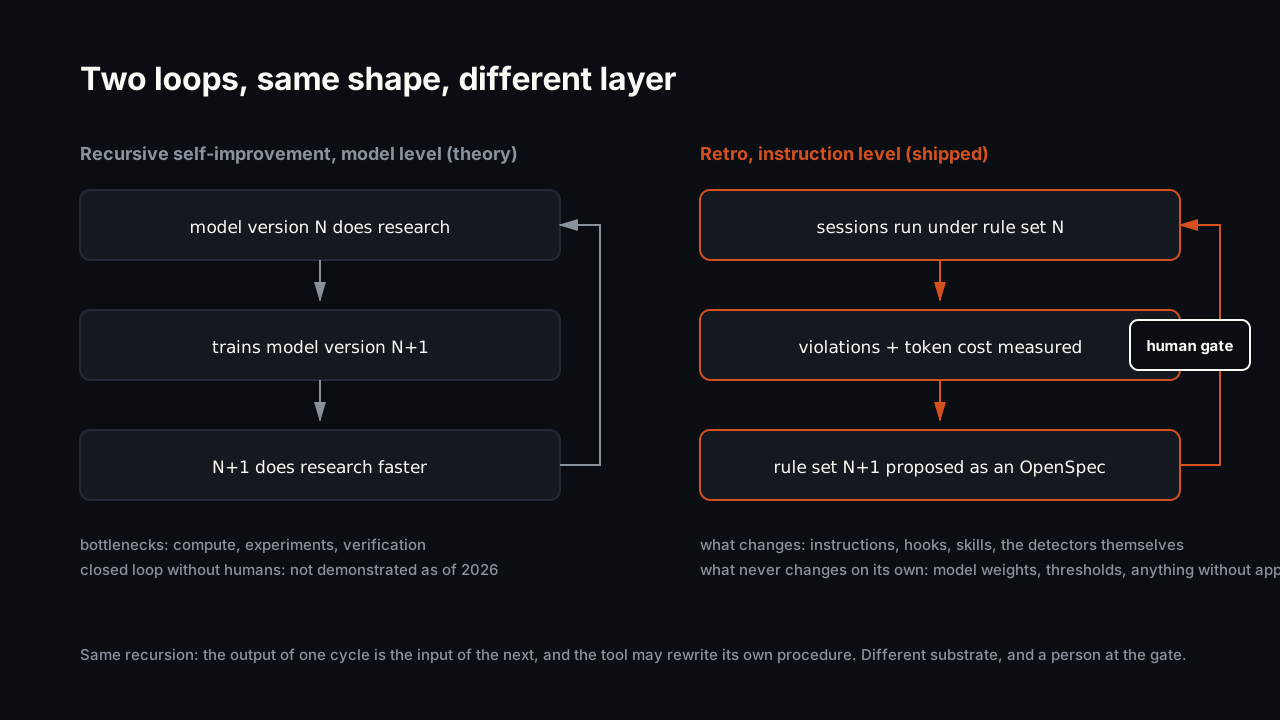
会话在规则集 N 下运行。一个 hook 记录每一次规则被打破,以及那次会话花了多少。一个分析器把记录变成报告。一个技能把报告变成规则集 N+1 的提案,包括对它自己的检测器和对它自身的修改。一个人逐行批准或驳回。下一轮衡量这次改动有没有让数字动起来。
这就是 Retro。同样的递归,不同的载体,回路上多了一个人。
Retro 记录什么
原材料早就存在。Claude Code 把每一次会话写到磁盘上,作为一份会话记录:每一次工具调用、它的输入、顺序、结果、每条消息的 token 用量。Coograph 已有的 hook 在代理编辑批准范围之外的文件、或碰到生成文件时本来就会触发;它们只是打印一条警告然后忘掉。我们加了一个 SessionEnd hook 来解析会话记录,让已有的 hook 在触发时写下一条记录,并给整件事定了一条关于记录可以包含什么的严格规则。
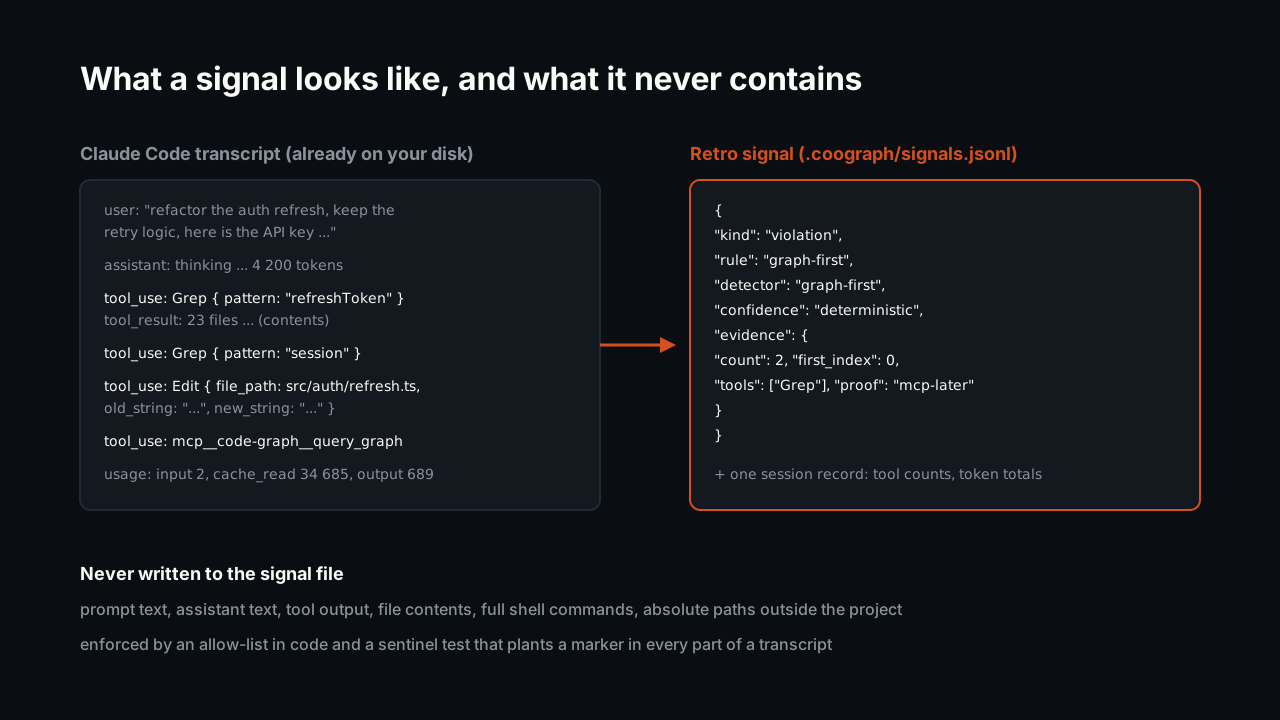
一条信号记录包含规则 id、是哪个检测器触发的、该检测器是确定性的还是启发式的,以及一个由计数、工具名、仓库相对路径和 shell 命令哈希组成的证据对象。它永远不包含提示文本、助手文本、工具输出、文件内容或完整命令。这不是一条政策,而是代码里的一份允许列表;还有一个测试会在一份合成会话记录的每个部分种下标记字符串,只要标记进了信号文件就失败。什么都不会上传到任何地方。文件就在你的项目里,被 git 忽略。
有七件事会被检测:在代码图之前 grep、没有批准变更的多文件编辑、批准变更之外的编辑、对生成文件的手工编辑、同一条构建命令连续失败三次、安装了新依赖、以及一条看起来像纠正的用户消息。其中后两项(多文件的猜测和纠正的猜测)被标为启发式,永远不能作为一处改动的唯一证据。每次会话还会得到一条摘要记录,包含工具计数和 token 总量,按消息去重,因为会话记录在每个内容块上都重复了用量。
Retro 提出什么
分析器是纯 Python,里面没有模型。它读取信号、规则注册表和已归档的变更,写出一份报告:每条规则对照它的阈值,附一列“升级到”;违规聚集的目录;构建重试;每次会话的 token,以最近一次规则改动为界做前后拆分;有多少编辑会话同时跑了评审;以及指令文件相对预算已经长到多大。
技能读取那份报告,用 Coograph 项目里其他所有变更同样的格式写出一份提案。允许五种改动:当证据显示歧义时改写一条规则,为没有任何规则覆盖的模式新增一条规则,为违规聚集的目录新增一份带作用域的指令文件,新增一个 hook,或者删掉一条十次会话里没人碰过的规则。
每一处提出的改动都以三句大白话开头。发生了什么。为什么重要。改什么。然后是一个证据块,里面的数字只来自报告。如果一个数字不在报告里,它就不在提案里。
循环的规则
这个循环有约束,因为一个不受约束地改写自己规则的循环,正是你一开始想摆脱的臃肿的来源。
一条仍在被违反的文字规则会被升级为 hook。它永远不会被改写得更大声。我们自己仓库的数据说,更大声没用;而一个赶时间的代理跳不过 hook。
启发式信号永远不是唯一证据。对用户情绪的猜测不会改变一条规则。
超出 token 预算后,每新增一条规则必须配对删掉一条。指令集不能仅仅因为循环发现了新东西就无限增长。
Retro 可以对它自己的技能、检测器和 hook 提出修改。这就是递归的部分。它不能改自己的阈值,也不能禁用某个检测器,除非提案里带着一条明确说明这一点的任务,因为一个能悄悄降低自己标准的循环,一定会这么做。
什么都不会自动应用。提案是一份 OpenSpec。你批准它、驳回它、或者划掉其中几行,和对待一个功能完全一样。
第一天,不是第二十天
对任何衡量工具的常见反对意见是,你得攒几周数据它才说得出东西。不用。Claude Code 一直在保存你的会话记录,放在一个以项目路径命名的目录下。初始化时会问你要不要读它们,于是第一份报告在安装结束前就装着你真实的会话。从没打开过 Retro、但已经归档了十个以上变更的项目,可以用一条命令引导启动;会话开始时的那一行会告诉他们。
那一行也是你得知有东西可看的方式。Coograph 项目里每一次 Claude Code 会话本来就会在顶部打印代码图状态。现在多打印一行,形如:已捕获十二次会话,三条规则超过阈值,运行 retro。没人需要记住某个步骤,也没人需要以“正确的方式”收尾一次变更循环才会注意到。
这不是什么
Retro 不训练任何东西。没有权重会改变。它不是 I. J. Good 所指的那种递归自我改进,我们也不会在销售材料里那样描述它。它是同一个循环的指令层版本:系统观察自身的失败,并对自身的脚手架提出修改,包括脚手架里负责观察的那部分。
两个诚实的警告。捕获只在 Claude Code 里有效,因为它是唯一同时暴露会话记录和生命周期 hook 的编程代理;Coograph 支持的另外七个工具能拿到分析器和技能,但拿不到记录。而这个循环能否在多轮之后持续找到改进,还没有被证明。我们的预期与上面的理论一致,是收益递减:第一次 retro 找到大部分价值,之后的越来越少。我们把衡量这件事的机制造了出来,所以几个月后我们会知道,而不是猜。
试一试
Retro 随 Coograph 1.1.0 发布,在 Claude 插件里,在初始化器里,也在让已注册项目保持最新的同步脚本里。检测器参考、注册表格式、阈值和测试都记录在仓库里。Retro 的文档页会带你走一遍会话开始那一行、报告、提案格式和各工具的支持表。
如果你已经在用 Coograph,拉一下代码,你的下一次会话就会告诉你有没有值得做一次 retro 的东西。如果还没有,初始化器会就此问你一个问题,然后读取你已经拥有的那些会话记录。
关于递归自我改进,有意思的问题从来不是这个循环是否可能。它的窄版本显然可能。问题是你让它改什么,你怎样衡量改动有没有帮助,以及谁有权说“可以”。我们选了指令、token 成本和违规计数,以及你。
削减你的 AI 编程账单 67–78%。Coograph 采用 MIT 许可、永久免费。Pro 提供定制服务。