我们用真实分词器重跑了基准测试。数字变低了。我们照样发布。
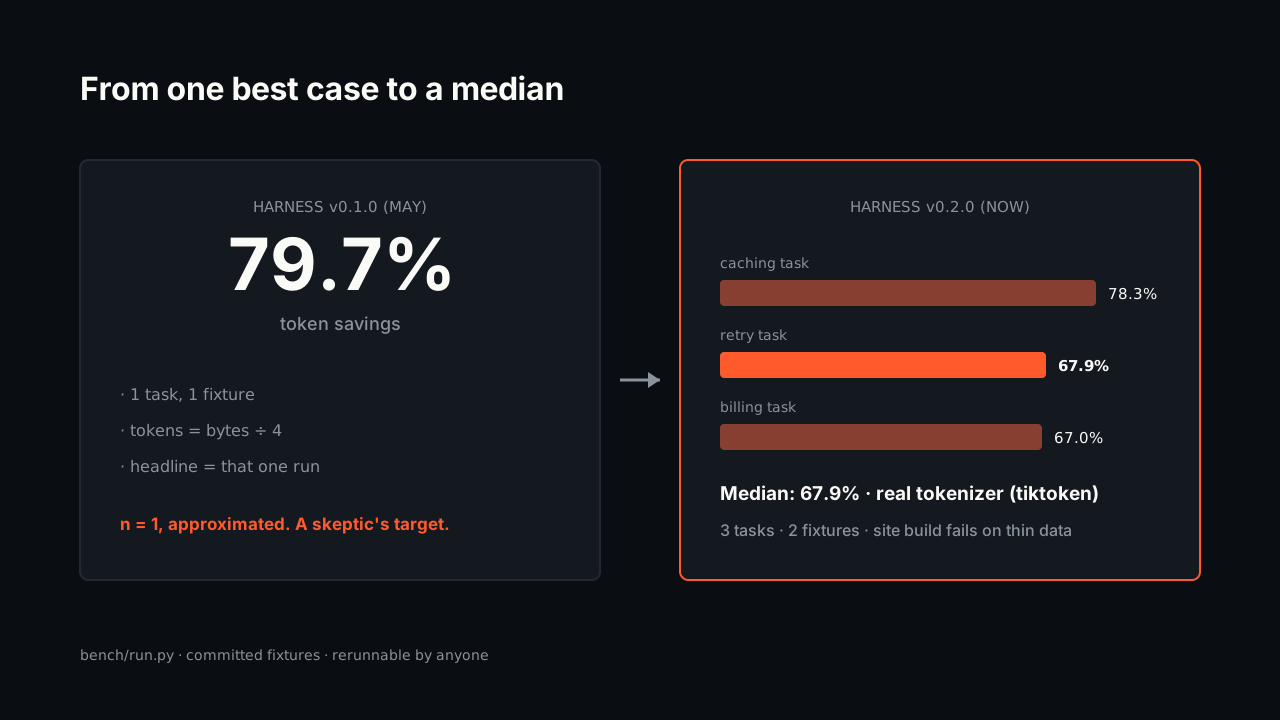
我们的头条宣称曾是省 79.7% token——单任务、单夹具、字节 ÷ 4。新测试台跑 3 项任务、用 tiktoken 统计,报告中位数:67.9%。为什么更低的数字更值钱,以及随之发布的新功能。
直到今天早上,Coograph 首页写的还是省约 80% token。这个数字是真的——但它来自一项任务、一个夹具,token 数用字节 ÷ 4 近似。一个已提交的最佳案例,标注得再诚实,也仍是单一最佳案例。
从今天起,页面上写的是 67.9%。产品没有变差。测量变好了。
为什么我们主动调低自己的头条
AI 开发工具市场有一个基准测试问题。厂商自测的数字到处都是;可独立验证的很少。2026 年赢得信任的工具,都是宣称经得起怀疑者重跑的那批——grepai 的普及靠的是独立验证过的基准,而厂商自报的「质量提升 70%+」这类说法一经接触就被打折。我们把 token 效率卖给一群职业性怀疑 token 效率宣称的人。唯一持久的做法,是把宣称变小、把证据变大。
所以测试台 v0.2.0 改了三件事:
- 三项任务、两个夹具,而不是一和一。一项 Python 缓存任务、一项 Python 账务任务、一项 TypeScript/React 重试任务——每项都是现实的修改,带着现实的误报分布(测试、文档、传输类型、提到关键词却无关紧要的下游调用方)。
- **真实 token 统计。**装有
tiktoken时,测试台统计实际 token 数(tiktoken/cl100k_base)而非字节 ÷ 4。所用方法记录在每份结果文件里。 - **头条是中位数,不是最佳案例。**逐任务:输入 token 分别省 78.3%、67.9%、67.0%;工具调用分别少 4.2×、2.75×、1.67×。网站头条:67.9% 和 2.75×——分布的中间,而非它讨喜的那一端。
随之而来两道护栏。任何任务,如果朴素 grep 命中的文件数不足其最小上下文文件数的 2 倍,会被测试台直接拒绝——你无法构造一个没有误报的夹具去收割虚高数字。而且网站构建现在会在结果文件缺失、任务少于 3 项、或引用了不再提交的夹具文件时直接失败。营销在字面意义上离开证据就无法上线。
约 68% 对你的账单仍然意味着什么
数字讲的故事没变,只是根基更扎实了:烧钱最多的是你代理的检索层,不是你的提示词纪律。关键词搜索返回一切提到某符号的东西;你正在做的修改只触及依赖路径上的几个文件。在我们的三项任务里,朴素流程每任务读 5–21 个文件,实际需要 2–4 个。乘上每个任务、每一天、每个席位——无论是在每周限额、按量计费的 Fable 5 还是支出上限之下——中位数就是结构化检索能追回的诚实下限。
图现在会给自己做预算
同一个版本发布了基准测试所论证的那个功能。get_review_context——把评审文件集交给代理的 MCP 工具——现在返回排序过、标好 token 价格的清单,而非无序集合,并接受预算:
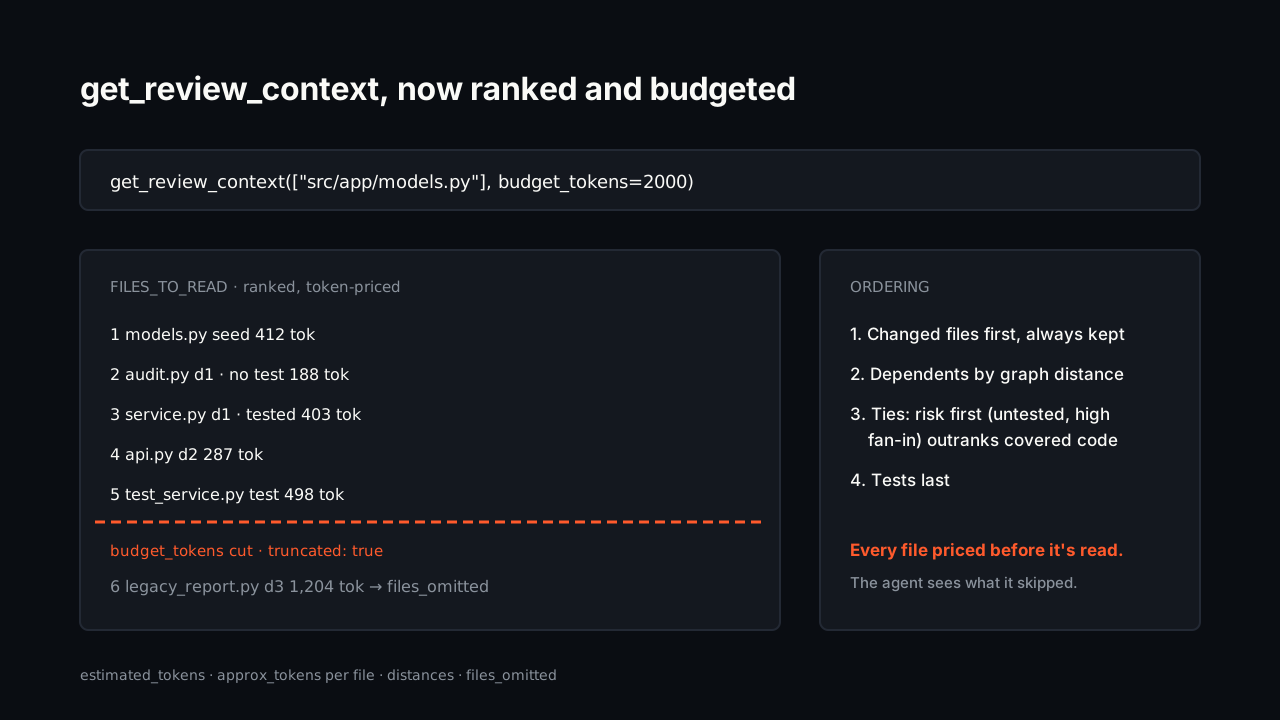
改动过的文件排最前且永不被裁掉。依赖方按图距离排列——直接导入者先于传递导入者——风险打破平局:未测试、高扇入的文件排在有覆盖的文件之前。测试收尾。每个条目带 approx_tokens 估算,budget_tokens 截断尾部的同时告诉代理究竟省略了什么,让「多读一点」变成一个显式的、标了价的决定,而非默认行为。这正是 2026 年成本文献不断收敛到的策展式检索模式——上下文筛选是基础设施,不是代理的自觉。
还有一套在工具层面盯着我们的测试台
基准测试检验宣称;它不检验产品。所以第三件事是 coograph-testbed:四个小而真实的项目——Python、TypeScript/React(含 tsconfig 路径别名)、Go、Java——由一个运行器像真实安装一样从零初始化、构建图,然后断言实际的 MCP 工具行为:各技术栈的依赖边、BFS 距离、排序顺序、每一种预算截断情形、编辑后的增量重建。
它不到一小时就回了本:编写断言时暴露出 query_graph("importers_of") 从未返回过结果——它拿原始导入字符串去匹配文件 ID,一个任何演示都不会暴露的 bug。已修复、已断言,今后每一次 code-graph 变更都以 4/4 技术栈全绿为门槛。
产品变差了吗?数字掉了 12 个点。
在原任务上产品没有变化——真实分词器下 78.3%,近似法下 79.7%。头条下降是因为它现在报告三项任务的中位数,而不是一个讨喜的个案。同一张图,更严的评分。
为什么用中位数,不用平均数或最佳任务?
中位数对单个讨喜(或不讨喜)的离群值稳健,而且它本来就是怀疑的读者会自己算的那个数。逐任务明细随每份结果文件发布——没有隐藏什么,精选任务仍然展示,只是不再充当头条。
3 项任务够吗?
不够——这是诚实的下限,而且少于它构建就拒绝上线。测试台现在靠增加 manifest 条目扩展,非平凡性护栏防止新任务放水。任务和夹具会随时间增加;中位数会随之移动,往哪边移就往哪边移。
这些我能验证吗?
能——这正是重点。夹具、manifest、测试台都已提交;python bench/run.py 在同一 git sha 上复现每个数字,每份结果记录夹具哈希和分词方法。testbed 仓库同样公开。如果你的重跑与我们的头条不符,请开 issue——那是我们宣称里的 bug。
开源还是收费?
全部——测试台、夹具、testbed、带预算的评审上下文——都是 MIT 许可、免费。Coograph Pro 是定制服务,包括用同一套基准方法论测量你实际的仓库和任务组合。
不能重跑的基准测试是广告。我们的基准在产品拿到预算参数的同一天,变得更小、也更难被反驳。从入门指南自己重跑一遍,读读 bench/README.md 里的方法论,或者联系我们,用同样的方式测量你自己的仓库。更低的那个数字,才是我们希望别人拿给我们看的数字。
削减你的 AI 编程账单 67–78%。Coograph 采用 MIT 许可、永久免费。Pro 提供定制服务。