我們用真實分詞器重跑了基準測試。數字變低了。我們照樣發布。
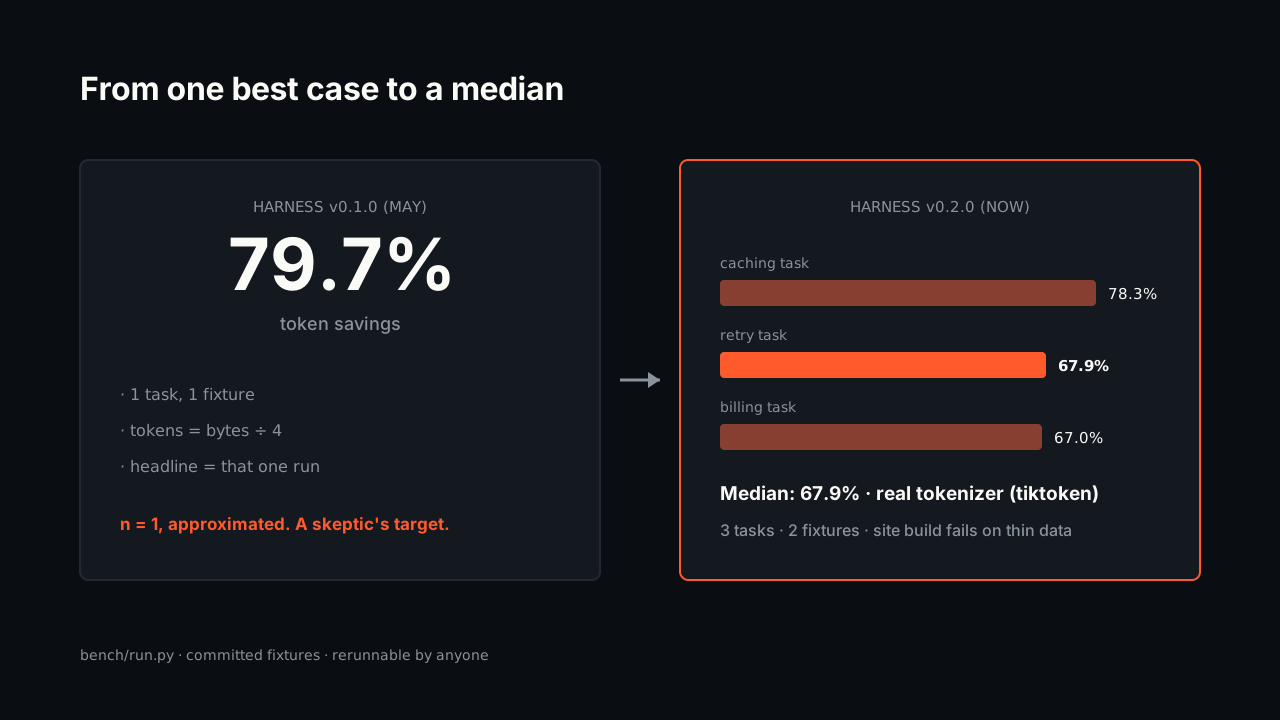
我們的頭條宣稱曾是省 79.7% token——單任務、單夾具、位元組 ÷ 4。新測試平台跑 3 項任務、用 tiktoken 統計,回報中位數:67.9%。為什麼更低的數字更值錢,以及隨之發布的新功能。
直到今天早上,Coograph 首頁寫的還是省約 80% token。這個數字是真的——但它來自一項任務、一個夾具,token 數用位元組 ÷ 4 近似。一個已提交的最佳案例,標註得再誠實,也仍是單一最佳案例。
從今天起,頁面上寫的是 67.9%。產品沒有變差。測量變好了。
為什麼我們主動調低自己的頭條
AI 開發工具市場有一個基準測試問題。廠商自測的數字到處都是;可獨立驗證的很少。2026 年贏得信任的工具,都是宣稱經得起懷疑者重跑的那批——grepai 的普及靠的是獨立驗證過的基準,而廠商自報的「品質提升 70%+」這類說法一經接觸就被打折。我們把 token 效率賣給一群職業性懷疑 token 效率宣稱的人。唯一持久的做法,是把宣稱變小、把證據變大。
所以測試平台 v0.2.0 改了三件事:
- 三項任務、兩個夾具,而不是一和一。一項 Python 快取任務、一項 Python 帳務任務、一項 TypeScript/React 重試任務——每項都是現實的修改,帶著現實的誤報分布(測試、文件、傳輸型別、提到關鍵字卻無關緊要的下游呼叫方)。
- **真實 token 統計。**裝有
tiktoken時,測試平台統計實際 token 數(tiktoken/cl100k_base)而非位元組 ÷ 4。所用方法記錄在每份結果檔案裡。 - **頭條是中位數,不是最佳案例。**逐任務:輸入 token 分別省 78.3%、67.9%、67.0%;工具呼叫分別少 4.2×、2.75×、1.67×。網站頭條:67.9% 和 2.75×——分布的中間,而非它討喜的那一端。
隨之而來兩道護欄。任何任務,如果樸素 grep 命中的檔案數不足其最小上下文檔案數的 2 倍,會被測試平台直接拒絕——你無法構造一個沒有誤報的夾具去收割虛高數字。而且網站建置現在會在結果檔案缺失、任務少於 3 項、或引用了不再提交的夾具檔案時直接失敗。行銷在字面意義上離開證據就無法上線。
約 68% 對你的帳單仍然意味著什麼
數字講的故事沒變,只是根基更紮實了:燒錢最多的是你代理的檢索層,不是你的提示詞紀律。關鍵字搜尋回傳一切提到某符號的東西;你正在做的修改只觸及依賴路徑上的幾個檔案。在我們的三項任務裡,樸素流程每任務讀 5–21 個檔案,實際需要 2–4 個。乘上每個任務、每一天、每個席位——無論是在每週限額、按量計費的 Fable 5 還是支出上限之下——中位數就是結構化檢索能追回的誠實下限。
圖現在會給自己做預算
同一個版本發布了基準測試所論證的那個功能。get_review_context——把評審檔案集交給代理的 MCP 工具——現在回傳排序過、標好 token 價格的清單,而非無序集合,並接受預算:
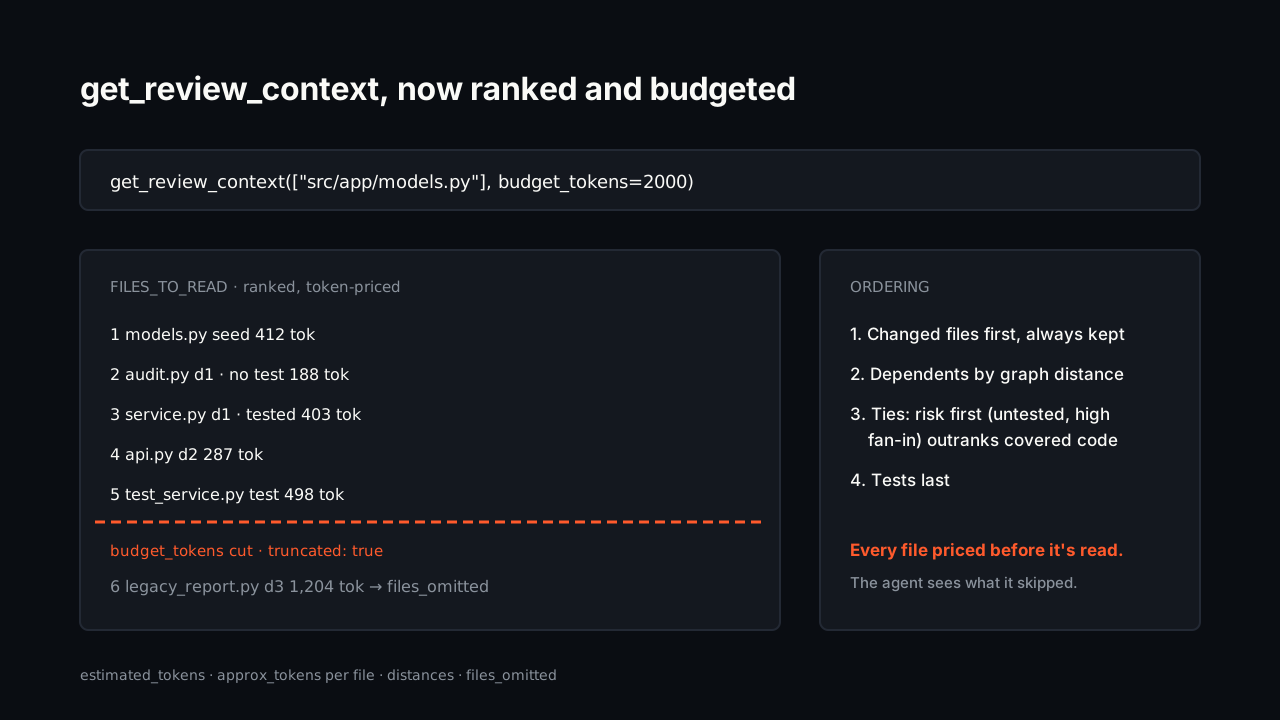
改動過的檔案排最前且永不被裁掉。依賴方按圖距離排列——直接匯入者先於傳遞匯入者——風險打破平手:未測試、高扇入的檔案排在有覆蓋的檔案之前。測試收尾。每個條目帶 approx_tokens 估算,budget_tokens 截斷尾部的同時告訴代理究竟省略了什麼,讓「多讀一點」變成一個顯式的、標了價的決定,而非預設行為。這正是 2026 年成本文獻不斷收斂到的策展式檢索模式——上下文篩選是基礎設施,不是代理的自覺。
還有一套在工具層面盯著我們的測試台
基準測試檢驗宣稱;它不檢驗產品。所以第三件事是 coograph-testbed:四個小而真實的專案——Python、TypeScript/React(含 tsconfig 路徑別名)、Go、Java——由一個執行器像真實安裝一樣從零初始化、建置圖,然後斷言實際的 MCP 工具行為:各技術棧的依賴邊、BFS 距離、排序順序、每一種預算截斷情形、編輯後的增量重建。
它不到一小時就回了本:編寫斷言時暴露出 query_graph("importers_of") 從未回傳過結果——它拿原始匯入字串去比對檔案 ID,一個任何展示都不會暴露的 bug。已修復、已斷言,今後每一次 code-graph 變更都以 4/4 技術棧全綠為門檻。
產品變差了嗎?數字掉了 12 個點。
在原任務上產品沒有變化——真實分詞器下 78.3%,近似法下 79.7%。頭條下降是因為它現在回報三項任務的中位數,而不是一個討喜的個案。同一張圖,更嚴的評分。
為什麼用中位數,不用平均數或最佳任務?
中位數對單個討喜(或不討喜)的離群值穩健,而且它本來就是懷疑的讀者會自己算的那個數。逐任務明細隨每份結果檔案發布——沒有隱藏什麼,精選任務仍然展示,只是不再充當頭條。
3 項任務夠嗎?
不夠——這是誠實的下限,而且少於它建置就拒絕上線。測試平台現在靠增加 manifest 條目擴展,非平凡性護欄防止新任務放水。任務和夾具會隨時間增加;中位數會隨之移動,往哪邊移就往哪邊移。
這些我能驗證嗎?
能——這正是重點。夾具、manifest、測試平台都已提交;python bench/run.py 在同一 git sha 上重現每個數字,每份結果記錄夾具雜湊和分詞方法。testbed 儲存庫同樣公開。如果你的重跑與我們的頭條不符,請開 issue——那是我們宣稱裡的 bug。
開源還是收費?
全部——測試平台、夾具、testbed、帶預算的評審上下文——都是 MIT 授權、免費。Coograph Pro 是客製服務,包括用同一套基準方法論測量你實際的儲存庫和任務組合。
不能重跑的基準測試是廣告。我們的基準在產品拿到預算參數的同一天,變得更小、也更難被反駁。從入門指南自己重跑一遍,讀讀 bench/README.md 裡的方法論,或者聯繫我們,用同樣的方式測量你自己的儲存庫。更低的那個數字,才是我們希望別人拿給我們看的數字。
削減你的 AI 編程帳單 67–78%。Coograph 採用 MIT 授權、永久免費。Pro 提供客製服務。