最好的新编程代理跑在一块 GPU 上。它的上下文是 131K,不是一百万。
Meta 的 Muse Glimmer 把真正的代理级编程模型放上了一块消费级显卡——Apache 2.0,131K 上下文。当 token 免费时,窗口就是电表。上下文效率不再是成本控制,而是能不能装下。
周一,Meta 带着 Muse Glimmer 重返开源:一个 Apache 2.0 许可的 30B 参数模型,专为代理工作训练——多步工具调用、编程、脚手架兼容、以及从失败的工具调用中恢复。据报道的规格才是重点:4-bit 量化后不到 20GB,跑在一块消费级 GPU 上,其中一个量化版本用 15.6GB 显存跑满全部 131K 上下文。同一周,阿里开始放出 Qwen3.8 的开放权重——包括约 2.4 万亿参数的旗舰。定义了 2026 年的开放模型浪潮,刚刚推进到这一步:一个真正能干活的编程代理,跑在你桌子底下那台机器上。
没有 API 账单。没有用量额度。没有每周上限。如果你一直在追我们关于 AI 成本电表的系列文章的话,这看起来像大结局:电表没了。
并没有。它又挪了位置——挪进了上下文窗口。
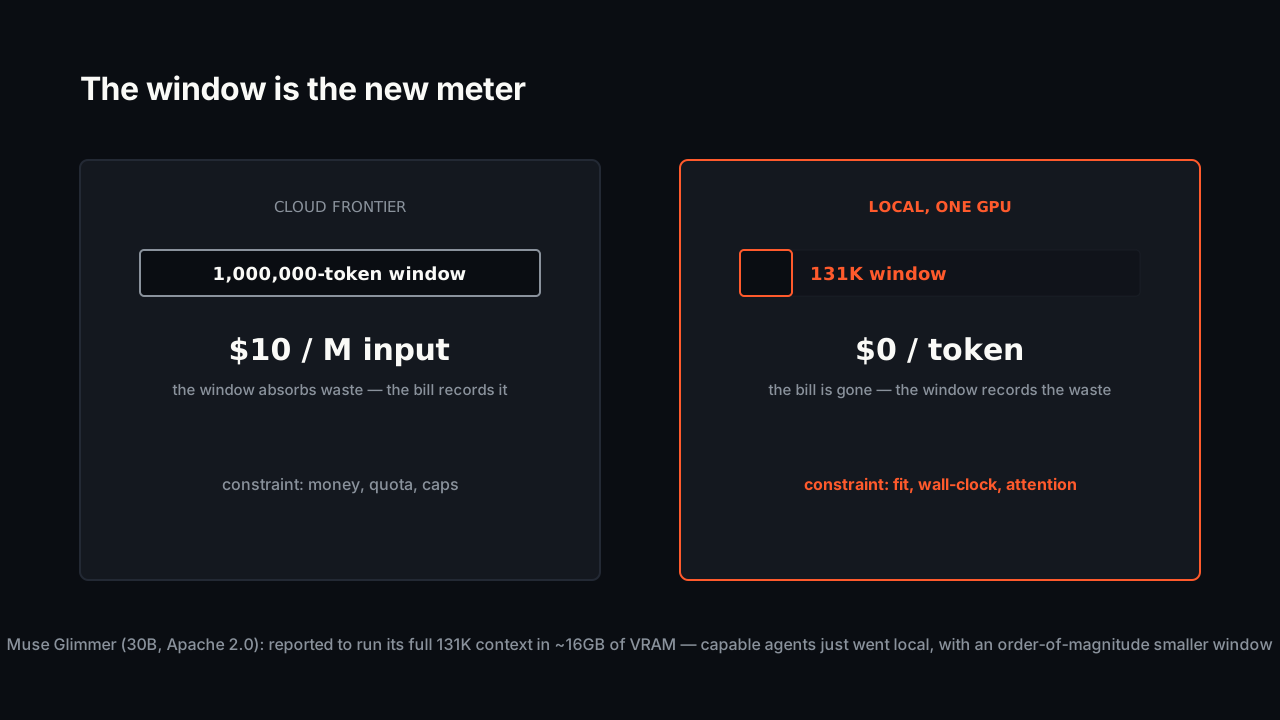
Token 免费了,三个约束还在
模型跑在本地,单 token 价格归零。三样东西没有归零:
**窗口是 131K,不是一百万。**云端前沿模型花了 2026 一整年把上下文卷到 100 万 token——大到能吸收粗糙的检索。本地模型活在小一个数量级的空间里。131K 是一笔真实的预算:系统提示、工具定义、会话历史、工具输出,还有代理决定读的每个文件,全都在抢同一块地方。没有溢出阀。窗口满了,代理就遗忘,或者失败。
**墙钟时间是新账单。**本地 GPU 按本地速度处理 token——Glimmer 的发布报道把 RTX 5090 上 3.1 倍的投机解码加速当卖点,恰恰因为吞吐是痛点。代理多吞的每个无用文件,都是你本人在每一轮里等模型重新注意那些它从不需要的噪声的秒数。
**注意力不是免费扩展的。**窗口塞得越满,模型推理得越差——上下文里松散相关的代码越多,答案质量磨损越大。云端也一样,但 30B 的本地模型比前沿模型更没有挥霍的余地。
我们成本系列里的规律换了标签继续成立:电表不断变形——配额、美元、上限,现在是装不装得下——杠杆始终不变。每任务 token 数在云端是你的成本控制。在本地,它决定代理能不能干活。
窗口的算术
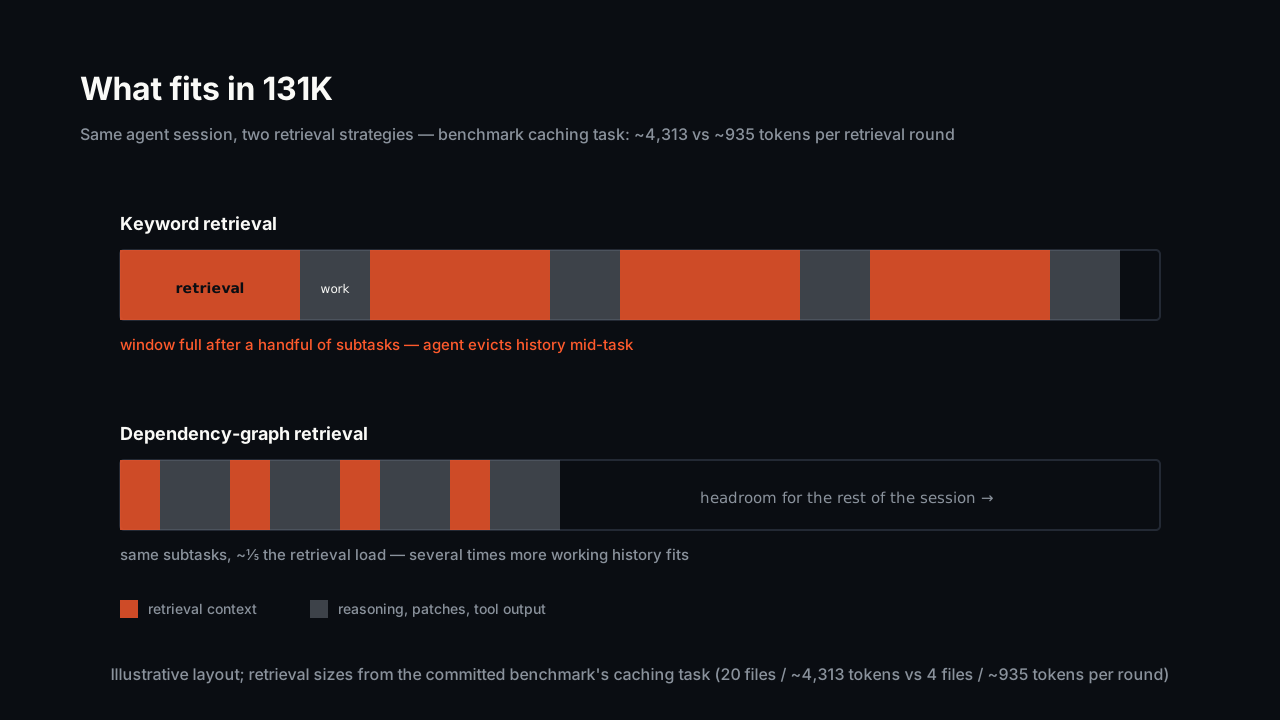
检索浪费吃掉 131K 有多快?我们的已提交基准(三个固定任务、两个 fixture,用真实 tokenizer 计数——全部进了版本库,可复跑)给出了形状。在缓存任务上,关键词检索读 20 个文件(约 4,313 输入 token,21 次工具调用),依赖图读 4 个文件(约 935 token,5 次调用)。
把它放进代理循环里。真实会话不是一轮检索——是每个子任务一轮:探索、打补丁、跑测试、读失败、再补。每轮约 4,300 token 的检索上下文,加上不断累积的工具输出和历史,几个子任务就深深咬进 131K 的预算,代理恰好在任务变得有意思的时候开始驱逐或截断。每轮约 900 token,同一个窗口能装下数倍的工作历史——这是”代理做完多步任务”和”代理中途丢线索”的区别。
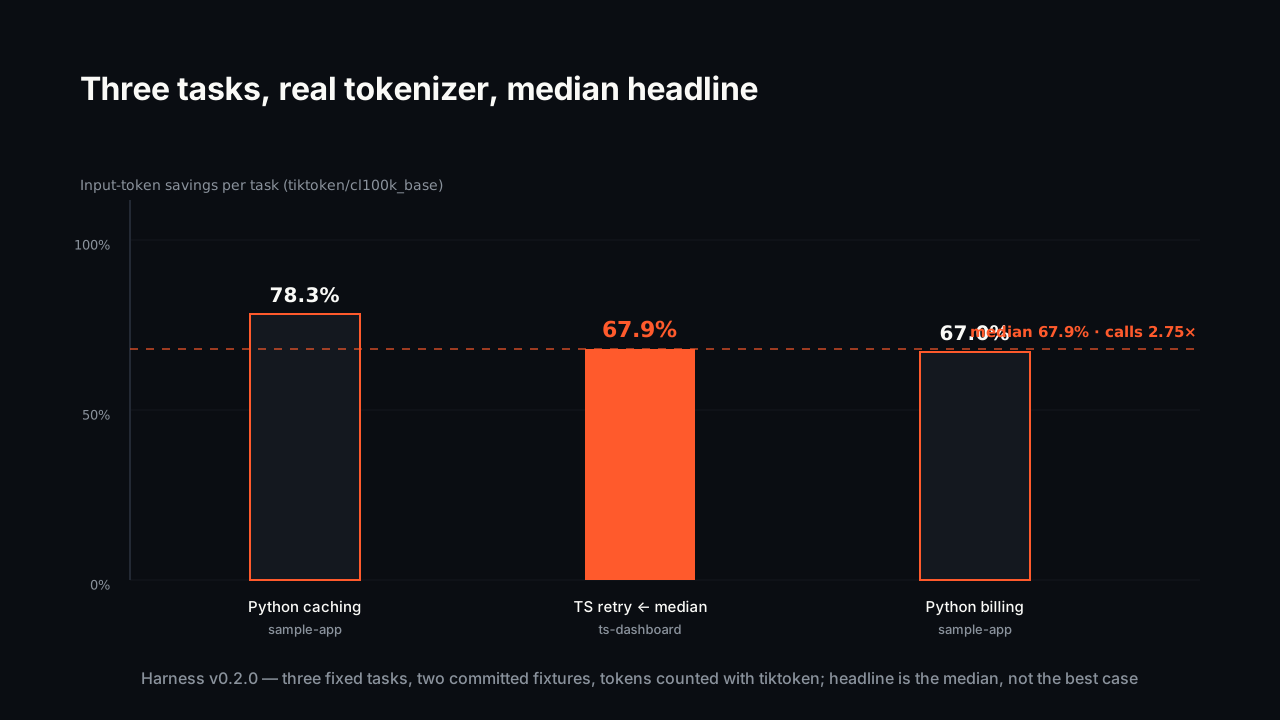
三个基准任务的中位数:输入 token 减少 67.9%,工具调用减少 2.75 倍(单任务分布:78.3%、67.9%、67.0%;4.2 倍、2.75 倍、1.67 倍)。三个固定任务的中位数,不是普适常数——真实数字由你的仓库决定。但在本地,省下的每个 token 结两次账:一次是窗口余量,一次是不用解码噪声的秒数。
完全本地的栈
本地浪潮还解锁了第二件事,对某些团队来说比免费 token 更重要:整个循环现在可以在代码不碰任何云的情况下跑完。
Muse Glimmer 是 Apache 2.0,在你的 GPU 上。Coograph 是 MIT,而且从第一天起就是本地的:它用 tree-sitter 解析你的代码库(Python、TypeScript、JavaScript、Go、Rust、Java、C#、Ruby 等,另有正则兜底),产出一个 SQLite 文件——.code-graph/graph.db——在你的磁盘上。你的代理通过 MCP(get_minimal_context、query_graph)查询它,一次拿到依赖链。git 钩子在每次提交时只重新解析变更的文件。没有嵌入服务,没有 API key,没有第三方看到你的一行源码。
模型在你的 GPU 上,图在你的磁盘上,代码在你的仓库里。对那些合规要求——或客户——不允许把源码送进云端模型的团队来说,“能干活的本地代理”曾是缺的那一块。它刚刚到货,而且带着一个小窗口到货:对这个栈来说,上下文层不是选装件。它是让 131K 够用的那个东西。
安装只要几分钟:把 Coograph 克隆为同级目录,在你的工具里(Claude Code、Copilot、Cursor、Windsurf、Codex CLI、OpenCode、Aider、Cline——任何会说 MCP 的)运行 /coograph-init,构建图。图不在乎谁来读它——今天是云端的 Fable 5,明天是桌子底下的 Muse Glimmer。
30B 的本地模型真的够干编程代理的活吗?
Meta 专门针对工具调用、编程代理、脚手架兼容和失败恢复训练了 Glimmer,并报告它在不到 16GB 显存里跑满 131K 上下文(发布时报道的数字)。它在最难的问题上比不过 Fable 5——但对代理实际承担的大量工作来说,“能干活、免费、私密”是一个严肃的选项。上下文层决定这份能力接触你的仓库后还剩多少。
本地 token 免费——为什么还要在乎 token 效率?
因为三种成本还在:131K 窗口(浪费填满它,代理就退化)、墙钟时间(本地 GPU 解码每个噪声 token 时你在等)、以及塞满上下文后的推理质量。在已提交基准上,图把输入 token 削减中位数 67.9%、工具调用 2.75 倍——在本地,这买到的是窗口余量和速度,不只是钱。
Coograph 能配本地模型吗?
能。Coograph 是架在本地 SQLite 图上的 MCP 服务器——任何会说 MCP 的代理脚手架都能查询它,背后是什么模型无所谓。它本来就是完全本地的,本地模型补全的是无云循环,不需要任何新东西。
这些基准数字哪来的?
Harness v0.2.0:两个已提交 fixture 上的三个固定任务,token 用 tiktoken(cl100k_base)计数,头条数字取中位数(token 67.9%,调用 2.75 倍;分布 67.0–78.3% 和 1.67–4.2 倍)。升级测量方法时我们主动调低了自己的头条数字。全部已提交——自己复跑。
开源还是付费?
整个仓库 MIT 许可、永久免费——没有付费墙功能。Coograph Pro 是定制服务(集成、内部语言的自定义解析器、针对你真实工作负载的基准测试),不是锁起来的产品档位。
云端用 2026 一整年教会所有人:上下文浪费费钱。本地浪潮教的是更锋利的一课:上下文浪费费能力。一个有纪律上下文层的 131K 窗口,胜过一个塞满噪声的百万窗口——而现在,证明这一点的整个栈就放在你桌子底下。用入门指南生成你的第一张图,在代码图页面看看里面有什么,或者如果你在搭无云循环,聊聊 Coograph Pro。基准已提交。在那台你的代码永远不用离开的机器上,复跑一遍。
削减你的 AI 编程账单 67–78%。Coograph 采用 MIT 许可、永久免费。Pro 提供定制服务。