最好的新編程代理跑在一塊 GPU 上。它的上下文是 131K,不是一百萬。
Meta 的 Muse Glimmer 把真正的代理級編程模型放上了一塊消費級顯卡——Apache 2.0,131K 上下文。當 token 免費時,視窗就是電錶。上下文效率不再是成本控制,而是能不能裝下。
週一,Meta 帶著 Muse Glimmer 重返開源:一個 Apache 2.0 授權的 30B 參數模型,專為代理工作訓練——多步工具呼叫、編程、鷹架相容、以及從失敗的工具呼叫中恢復。據報導的規格才是重點:4-bit 量化後不到 20GB,跑在一塊消費級 GPU 上,其中一個量化版本用 15.6GB 顯存跑滿全部 131K 上下文。同一週,阿里開始放出 Qwen3.8 的開放權重——包括約 2.4 兆參數的旗艦。定義了 2026 年的開放模型浪潮,剛剛推進到這一步:一個真正能幹活的編程代理,跑在你桌子底下那台機器上。
沒有 API 帳單。沒有用量額度。沒有每週上限。如果你一直在追我們關於 AI 成本電錶的系列文章的話,這看起來像大結局:電錶沒了。
並沒有。它又挪了位置——挪進了上下文視窗。
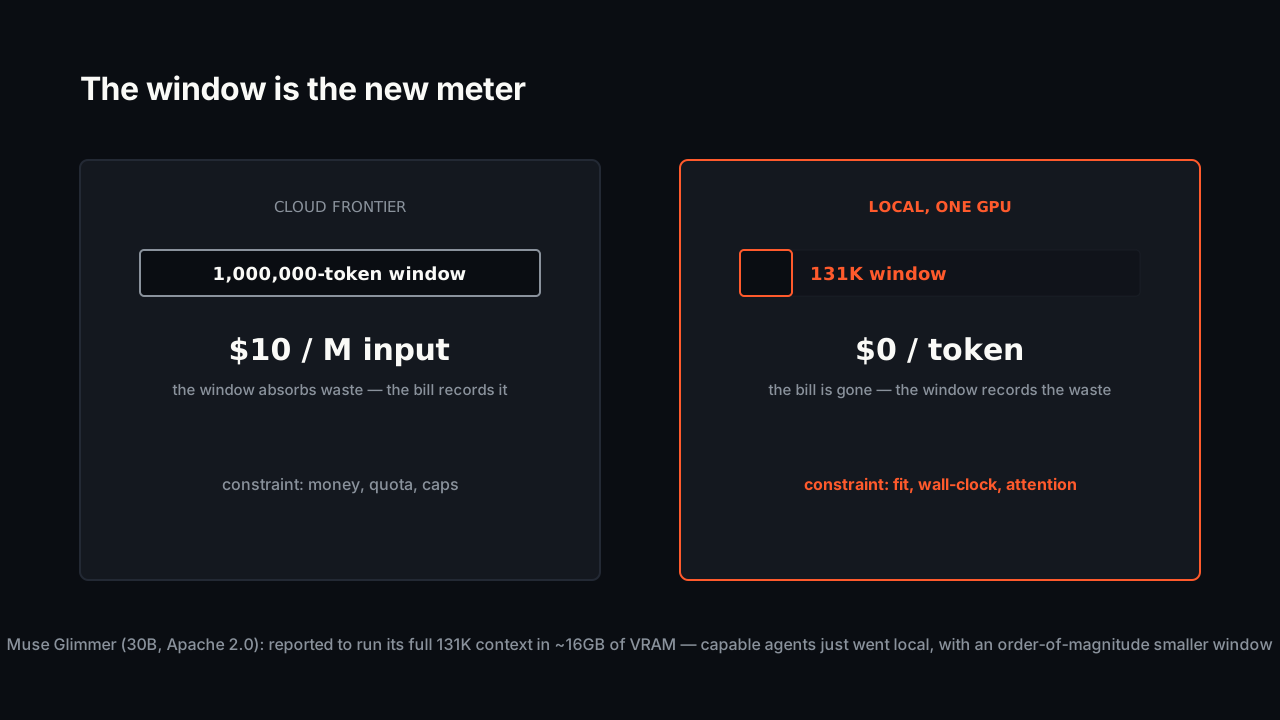
Token 免費了,三個約束還在
模型跑在本地,單 token 價格歸零。三樣東西沒有歸零:
**視窗是 131K,不是一百萬。**雲端前沿模型花了 2026 一整年把上下文捲到 100 萬 token——大到能吸收粗糙的檢索。本地模型活在小一個數量級的空間裡。131K 是一筆真實的預算:系統提示、工具定義、會話歷史、工具輸出,還有代理決定讀的每個檔案,全都在搶同一塊地方。沒有溢出閥。視窗滿了,代理就遺忘,或者失敗。
**牆鐘時間是新帳單。**本地 GPU 按本地速度處理 token——Glimmer 的發布報導把 RTX 5090 上 3.1 倍的投機解碼加速當賣點,恰恰因為吞吐是痛點。代理多吞的每個無用檔案,都是你本人在每一輪裡等模型重新注意那些它從不需要的雜訊的秒數。
**注意力不是免費擴展的。**視窗塞得越滿,模型推理得越差——上下文裡鬆散相關的程式碼越多,答案品質磨損越大。雲端也一樣,但 30B 的本地模型比前沿模型更沒有揮霍的餘地。
我們成本系列裡的規律換了標籤繼續成立:電錶不斷變形——配額、美元、上限,現在是裝不裝得下——槓桿始終不變。每任務 token 數在雲端是你的成本控制。在本地,它決定代理能不能幹活。
視窗的算術
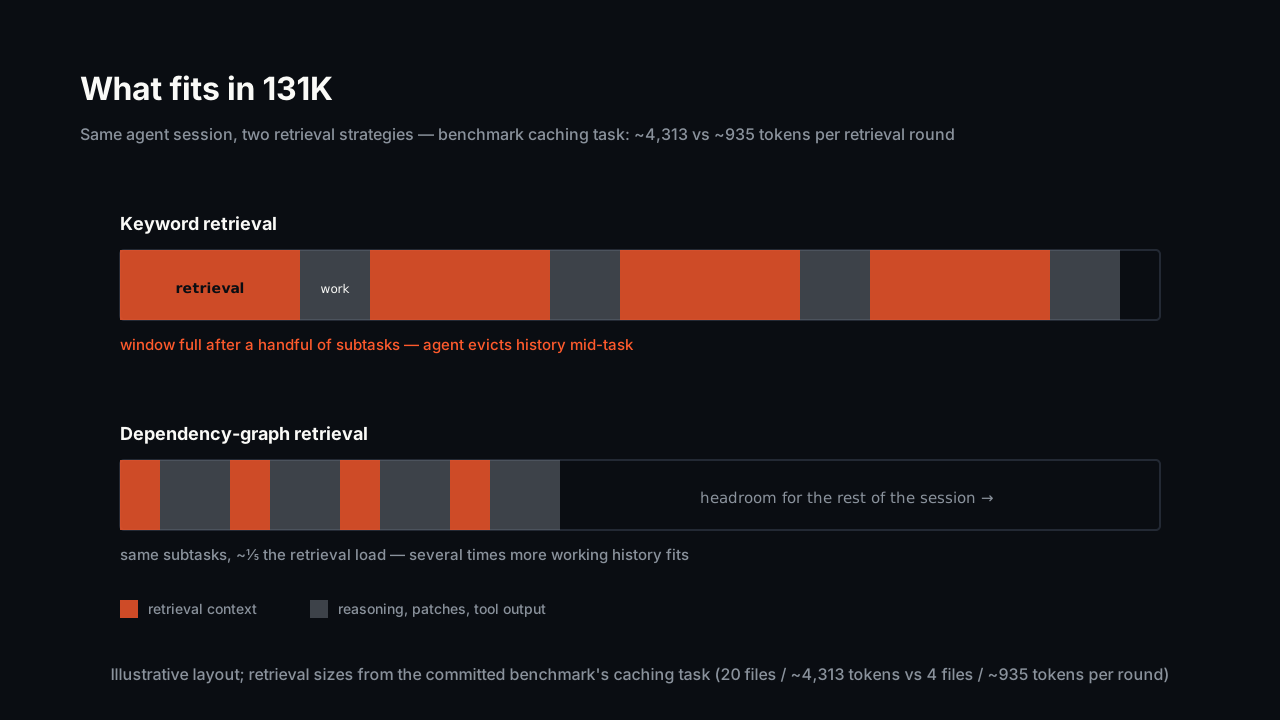
檢索浪費吃掉 131K 有多快?我們的已提交基準(三個固定任務、兩個 fixture,用真實 tokenizer 計數——全部進了版本庫,可重跑)給出了形狀。在快取任務上,關鍵字檢索讀 20 個檔案(約 4,313 輸入 token,21 次工具呼叫),依賴圖讀 4 個檔案(約 935 token,5 次呼叫)。
把它放進代理迴圈裡。真實會話不是一輪檢索——是每個子任務一輪:探索、打補丁、跑測試、讀失敗、再補。每輪約 4,300 token 的檢索上下文,加上不斷累積的工具輸出和歷史,幾個子任務就深深咬進 131K 的預算,代理恰好在任務變得有意思的時候開始驅逐或截斷。每輪約 900 token,同一個視窗能裝下數倍的工作歷史——這是「代理做完多步任務」和「代理中途丟線索」的區別。
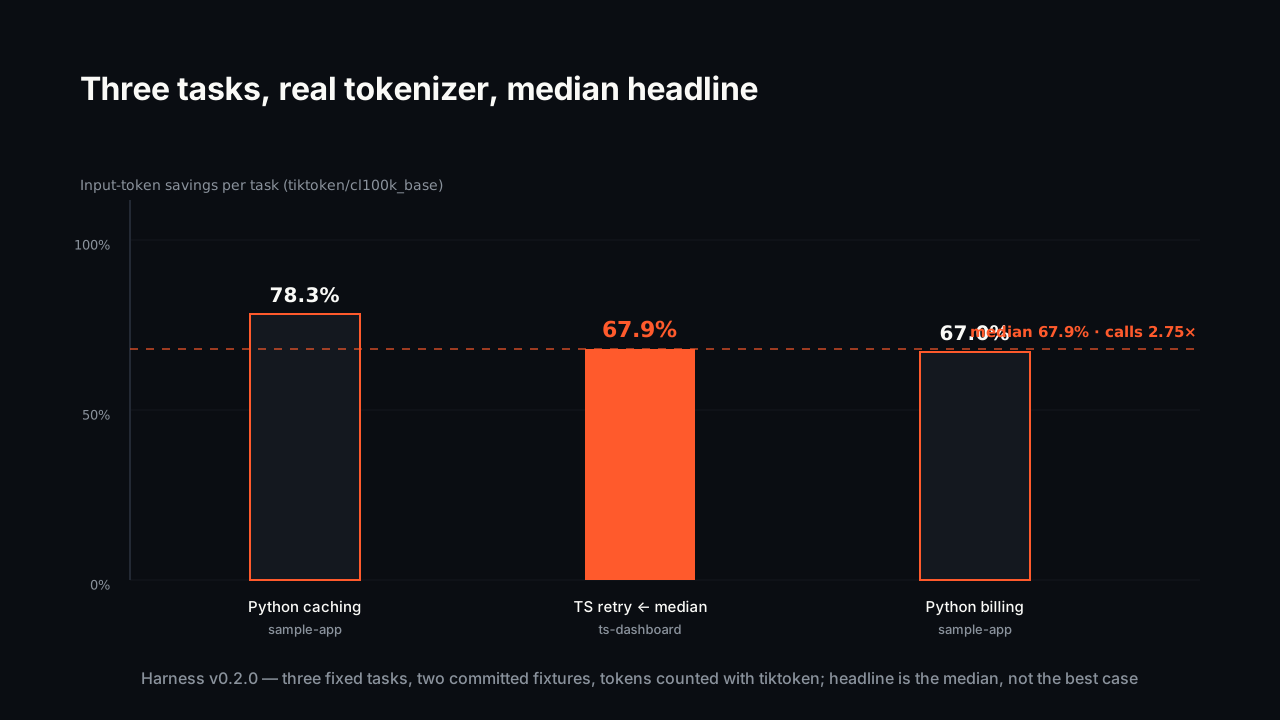
三個基準任務的中位數:輸入 token 減少 67.9%,工具呼叫減少 2.75 倍(單任務分布:78.3%、67.9%、67.0%;4.2 倍、2.75 倍、1.67 倍)。三個固定任務的中位數,不是普適常數——真實數字由你的倉庫決定。但在本地,省下的每個 token 結兩次帳:一次是視窗餘量,一次是不用解碼雜訊的秒數。
完全本地的棧
本地浪潮還解鎖了第二件事,對某些團隊來說比免費 token 更重要:整個迴圈現在可以在程式碼不碰任何雲的情況下跑完。
Muse Glimmer 是 Apache 2.0,在你的 GPU 上。Coograph 是 MIT,而且從第一天起就是本地的:它用 tree-sitter 解析你的程式碼庫(Python、TypeScript、JavaScript、Go、Rust、Java、C#、Ruby 等,另有正則兜底),產出一個 SQLite 檔案——.code-graph/graph.db——在你的磁碟上。你的代理透過 MCP(get_minimal_context、query_graph)查詢它,一次拿到依賴鏈。git 鉤子在每次提交時只重新解析變更的檔案。沒有嵌入服務,沒有 API key,沒有第三方看到你的一行原始碼。
模型在你的 GPU 上,圖在你的磁碟上,程式碼在你的倉庫裡。對那些合規要求——或客戶——不允許把原始碼送進雲端模型的團隊來說,「能幹活的本地代理」曾是缺的那一塊。它剛剛到貨,而且帶著一個小視窗到貨:對這個棧來說,上下文層不是選配。它是讓 131K 夠用的那個東西。
安裝只要幾分鐘:把 Coograph 克隆為同級目錄,在你的工具裡(Claude Code、Copilot、Cursor、Windsurf、Codex CLI、OpenCode、Aider、Cline——任何會說 MCP 的)執行 /coograph-init,建構圖。圖不在乎誰來讀它——今天是雲端的 Fable 5,明天是桌子底下的 Muse Glimmer。
30B 的本地模型真的夠幹編程代理的活嗎?
Meta 專門針對工具呼叫、編程代理、鷹架相容和失敗恢復訓練了 Glimmer,並報告它在不到 16GB 顯存裡跑滿 131K 上下文(發布時報導的數字)。它在最難的問題上比不過 Fable 5——但對代理實際承擔的大量工作來說,「能幹活、免費、私密」是一個嚴肅的選項。上下文層決定這份能力接觸你的倉庫後還剩多少。
本地 token 免費——為什麼還要在乎 token 效率?
因為三種成本還在:131K 視窗(浪費填滿它,代理就退化)、牆鐘時間(本地 GPU 解碼每個雜訊 token 時你在等)、以及塞滿上下文後的推理品質。在已提交基準上,圖把輸入 token 削減中位數 67.9%、工具呼叫 2.75 倍——在本地,這買到的是視窗餘量和速度,不只是錢。
Coograph 能配本地模型嗎?
能。Coograph 是架在本地 SQLite 圖上的 MCP 伺服器——任何會說 MCP 的代理鷹架都能查詢它,背後是什麼模型無所謂。它本來就是完全本地的,本地模型補全的是無雲迴圈,不需要任何新東西。
這些基準數字哪來的?
Harness v0.2.0:兩個已提交 fixture 上的三個固定任務,token 用 tiktoken(cl100k_base)計數,頭條數字取中位數(token 67.9%,呼叫 2.75 倍;分布 67.0–78.3% 和 1.67–4.2 倍)。升級測量方法時我們主動調低了自己的頭條數字。全部已提交——自己重跑。
開源還是付費?
整個倉庫 MIT 授權、永久免費——沒有付費牆功能。Coograph Pro 是客製服務(整合、內部語言的自訂解析器、針對你真實工作負載的基準測試),不是鎖起來的產品檔位。
雲端用 2026 一整年教會所有人:上下文浪費費錢。本地浪潮教的是更鋒利的一課:上下文浪費費能力。一個有紀律上下文層的 131K 視窗,勝過一個塞滿雜訊的百萬視窗——而現在,證明這一點的整個棧就放在你桌子底下。用入門指南生成你的第一張圖,在程式碼圖頁面看看裡面有什麼,或者如果你在搭無雲迴圈,聊聊 Coograph Pro。基準已提交。在那台你的程式碼永遠不用離開的機器上,重跑一遍。
削減你的 AI 編程帳單 67–78%。Coograph 採用 MIT 授權、永久免費。Pro 提供客製服務。